Full-Stack AI Infrastructure

GPUクラウド・専用クラスター・構築運用支援

単一GPUインスタンスから大規模ベアメタルクラスターまで。3つのサービス形態でお客様のあらゆるAIインフラニーズに対応します。利用可能な構成と提供条件は個別にご案内します。

Full-Stack AI Infrastructure

何を実現したいですか?

目的に近い項目から、サービスの特徴と検討ポイントをご確認いただけます。具体的な構成や担当範囲は、ご相談内容に応じて整理します。

小規模にAI開発・検証を始めたい

必要な期間や利用量に合わせて、GPU環境の利用を検討したい方へ。

パブリッククラウドGPU

自社専用のAI計算環境を整えたい

処理規模やデータの取り扱いに合わせて、専用環境を検討したい方へ。

プライベートAIクラスター

AIインフラの構築・運用を任せたい

構築、監視、保守などの負担を整理し、運用支援を検討したい方へ。

マネージドAIファクトリー

提供準備中

業務や自社サービスにAI推論を組み込みたい

AIによる回答生成や文書処理を支える推論サービスを検討したい方へ。

Token Factory

違いを比較して選びたい方へ

3つのサービスを比較する

サービス提供フロー

01

ヒアリング

お客様のAIワークロード・要件・予算を丁寧にヒアリングします。

02

提案・設計

最適なサービス形態とインフラ構成を設計し、詳細な提案書を作成します。

03

導入・構築

承認後、専門チームが迅速かつ確実に導入・構築を実施します。

04

運用・改善

稼働後も継続的な監視・改善でお客様のAIインフラを支え続けます。

Public Cloud
01 / Public Cloud

パブリック クラウド

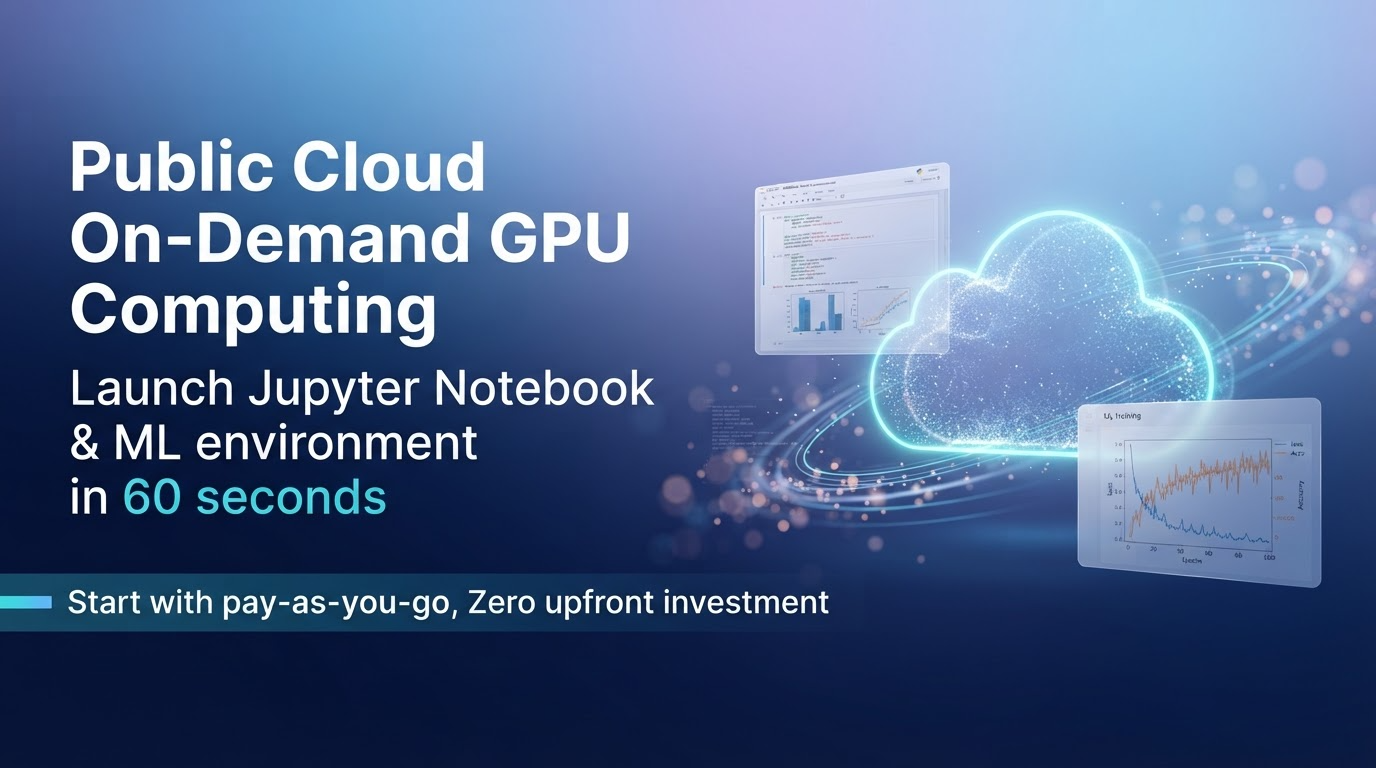
開発者フレンドリーなオンデマンドコンピュートサービスです。Jupyter NotebookやML環境を迅速に起動でき、スモールスタートから始められる従量課金モデルを採用しています。

  • 迅速な環境起動 — Jupyter NotebookとML環境をすばやく起動。開発をすぐに開始できます。
  • 従量課金モデル — 使った分だけ支払う柔軟な料金体系。初期費用を抑えてスタートできます。
  • 豊富なGPUラインナップ — NVIDIA H100、A100、L40Sなど最新GPUを単一インスタンスから利用可能。
  • 開発者フレンドリー — REST API、CLI、Webコンソールでリソースを管理。DevOpsワークフローに統合できます。
パブリッククラウドについて相談する
Private AI Cluster

800G

InfiniBand

5,000

Max GPU

専有

Bare-Metal

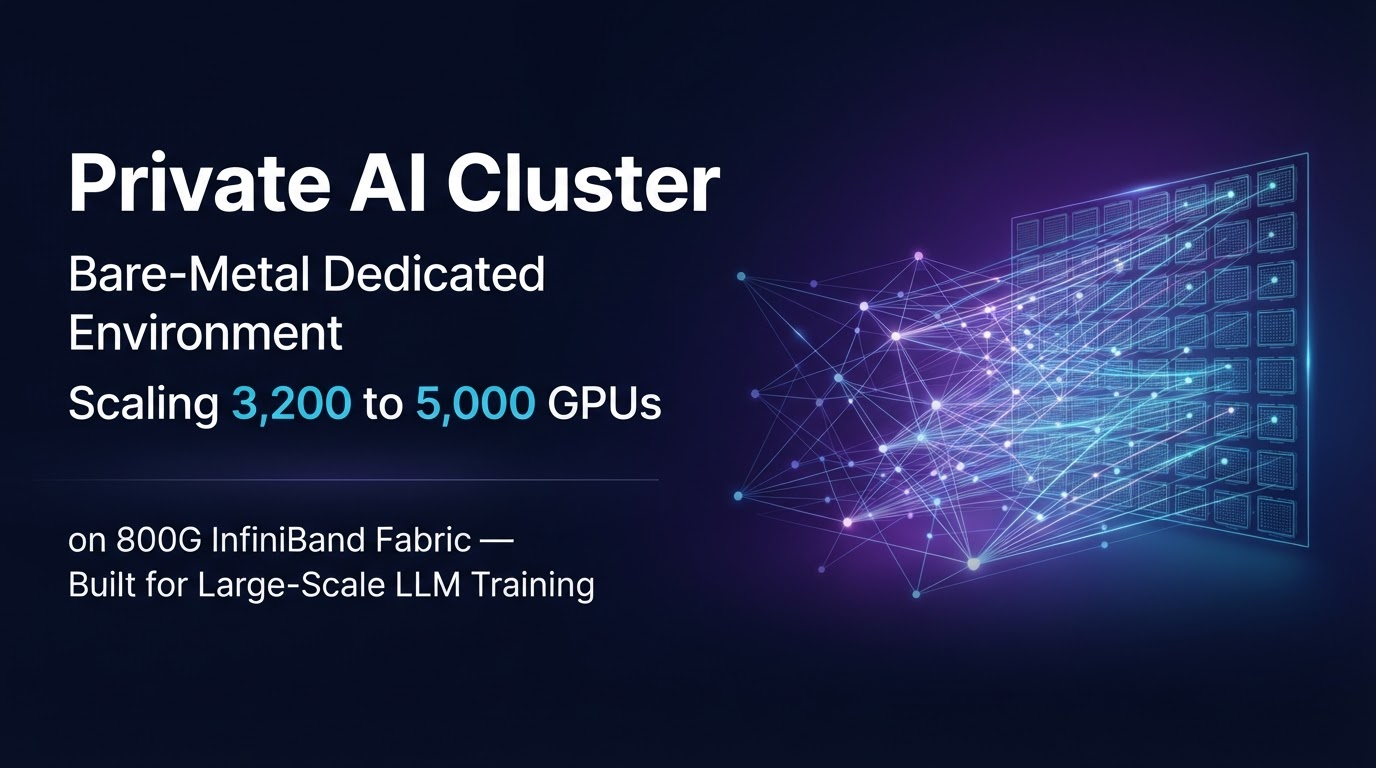
※800G InfiniBand・最大5,000 GPUはパートナー設備を活用した提供。構成・条件は個別にご案内します。

02 / Private AI Cluster

プライベート AIクラスター

Tier-1クライアント向けベアメタルクラスターです。高速ネットワークファブリックで大規模GPUクラスターを構成し、専有環境で安定したパフォーマンスを実現します。利用可能な構成と提供条件は個別にご案内します。

高速ネットワークファブリック

超低遅延・超高帯域のネットワークで、GPUノード間の通信を最適化します。

大規模GPUクラスター

大規模LLMトレーニングやシミュレーションに対応するGPUクラスター構成をご提案します。

専有ベアメタル環境

他テナントとリソースを共有しない完全専有環境。セキュリティと安定性を確保します。

カスタム構成対応

ネットワーク構成、ストレージ、冷却システムまでお客様の要件に合わせてカスタマイズします。

プライベートクラスターについて相談する
Managed AI Factory

インフラ構成の概要

高速

ネットワーク

InfiniBand対応

大規模

GPU規模

ベアメタル

迅速

起動時間

クラウド環境

高可用

稼働率

条件は個別案内

03 / Managed AI Factory

マネージド AIファクトリー

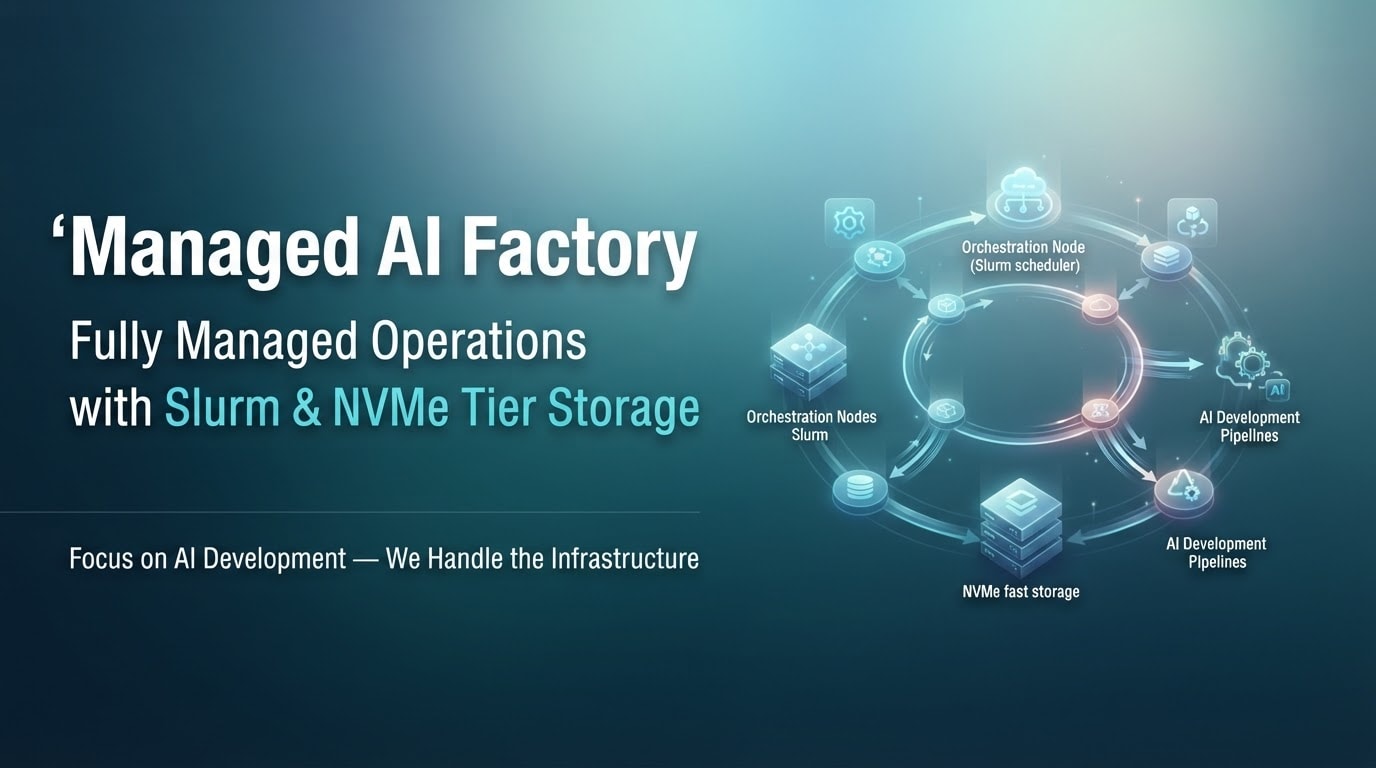
フルマネージド運用サービスです。高速ネットワーク、NVMe階層型ストレージ、Slurmオーケストレーションを含む環境をbloomaxが構築・運用し、AIワークロードに集中できる環境を提供します。

  • Slurmオーケストレーション — 業界標準のSlurmジョブスケジューラーで、大規模HPCワークロードを効率的に管理します。
  • NVMe階層型ストレージ — 高速NVMe SSDと大容量HDDを組み合わせた階層型ストレージで、I/O性能を最適化します。
  • 高速ネットワーク — 高帯域ネットワークで、ノード間通信を最適化しトレーニング効率を向上させます。
  • フルマネージド運用 — 監視・障害対応・メンテナンスをすべて代行。お客様はAI開発に集中できます。
マネージドAIファクトリーについて相談する
サービス比較

3つのサービス形態を比較する

パブリッククラウドGPU

想定用途

開発・検証・スモールスタート

環境の形態

オンデマンド(従量課金)

構築・運用の担当範囲

お客様が自己管理

相談時の確認事項

利用するGPU種別・利用量・期間

プライベートAIクラスター

想定用途

大規模LLMトレーニング・推論

環境の形態

専有(ベアメタル)

構築・運用の担当範囲

構築支援はbloomaxが対応(運用体制は個別相談)

相談時の確認事項

必要GPU数・ネットワーク要件・セキュリティ要件

マネージドAIファクトリー

想定用途

AIワークロードの継続運用

環境の形態

フルマネージド(詳細は個別案内)

構築・運用の担当範囲

構築・運用ともにbloomaxが担当

相談時の確認事項

ワークロード内容・SLA要件・運用体制

各サービスの提供条件・料金・対応範囲は個別にご案内します。下記は現在公開している情報に基づく概要です。

CONSULTATION EXAMPLES

こんな段階から、ご相談いただけます。

必要なGPUが分からない。専用環境を検討したい。構築や運用をどこまで任せられるか知りたい。bloomaxは、お客様の課題と利用条件を整理し、用途に合ったAIインフラの導入を支援します。仕様や構成が固まっていない段階でも、ご相談ください。

以下は想定されるご相談例です。実際の導入実績を示すものではありません。提供範囲や条件は個別にご案内します。

01

AI開発・検証用のGPUを利用したい

こんなお悩みに

AIモデルの検証を始めたいものの、どのGPUを選べばよいか、どれくらいの計算環境が必要か分からない。設備購入の前に、クラウド環境で試せる方法を検討したい。

相談で整理すること

  • 使用するモデルと処理内容(学習・推論など)
  • 扱うデータ量と必要なGPUメモリの目安
  • 利用人数・検証期間・予算
  • 既存の開発環境やデータの取り扱い条件

検討する構成・進め方

パブリッククラウドGPUを選択肢として、検証内容に合った環境を検討します。何を試し、どの条件を評価するかを整理したうえで、利用可能なGPUや提供条件をご案内します。

02

自社専用のAI計算環境を整えたい

こんなお悩みに

AIの継続利用や処理量の増加に向けて、専用GPUクラスターを検討したい。性能だけでなく、既存システムとの接続や、データの取り扱い、運用体制まで含めて考えたい。

相談で整理すること

  • 実行するAIワークロードと想定する処理量
  • 必要なGPU構成と将来の拡張計画
  • ネットワーク・ストレージの要件
  • データの設置場所・アクセス管理・既存システムとの接続
  • 導入時期・予算・社内の運用体制

検討する構成・進め方

専用GPUクラスターを選択肢として、計算資源・ネットワーク・ストレージを含めた構成を検討します。お客様、bloomax、必要に応じて連携する技術パートナーの担当範囲を整理し、導入に向けた条件を確認します。

03

AIインフラの構築・運用の負担を減らしたい

こんなお悩みに

AI開発を進めたい一方で、インフラの構築、監視、保守まで社内で対応するのは難しい。自社で担う業務と外部に任せる業務を整理し、継続して運用できる体制を検討したい。

相談で整理すること

  • 現在の設備やシステム構成
  • 社内の担当者と対応可能な業務範囲
  • 監視・保守・障害対応に求める条件
  • 更新や構成変更の進め方
  • 運用予算と必要なサポート範囲

検討する構成・進め方

マネージドAIファクトリーを選択肢として、構築・運用の支援範囲を検討します。既存設備の活用可否も含め、実際に対応できる作業、責任分担、連絡体制、契約条件を個別に整理します。

FAQ

ご相談前のよくある質問

必要な構成、費用の考え方、導入後の運用について、ご相談前に確認しておきたい点をまとめました。仕様や条件が固まっていない段階でも、ご相談いただけます。

条件が固まっていなくても、ご相談ください。

用途や課題をお聞かせいただくところから、導入に向けた検討を支援します。

AIインフラについて相談する