GPU云、专用集群与基础设施建设运营支持
从单一GPU实例到大规模裸金属集群。以三种服务形态满足客户的各类AI基础设施需求。可用配置和提供条件将单独告知。
您希望实现什么目标?
请选择与您目标最接近的选项,查看相关服务的特点与考量要点。具体配置和职责范围将根据咨询内容逐一整理。
希望小规模开展AI开发或验证
适合希望根据所需时间和使用量灵活使用GPU环境的用户。
公有云GPU
希望搭建专属AI计算环境
适合希望根据处理规模和数据管理需求搭建专用环境的用户。
私有AI集群
希望将AI基础设施的构建与运营交由专业团队负责
适合希望通过托管支持减轻构建、监控和维护负担的用户。
托管AI工厂
希望将AI推理能力集成到业务或自有产品中
适合希望借助推理服务支持AI回答生成和文档处理的用户。
Token Factory
希望对比各服务后再做选择?
对比三项服务服务提供流程
需求调研
详细了解客户的AI工作负载、需求和预算。
方案设计
设计最优服务形态和基础设施配置,制作详细提案书。
导入建设
获批后,专业团队迅速可靠地完成导入和建设。
运营优化
上线后持续监控和优化,持续支撑客户的AI基础设施。
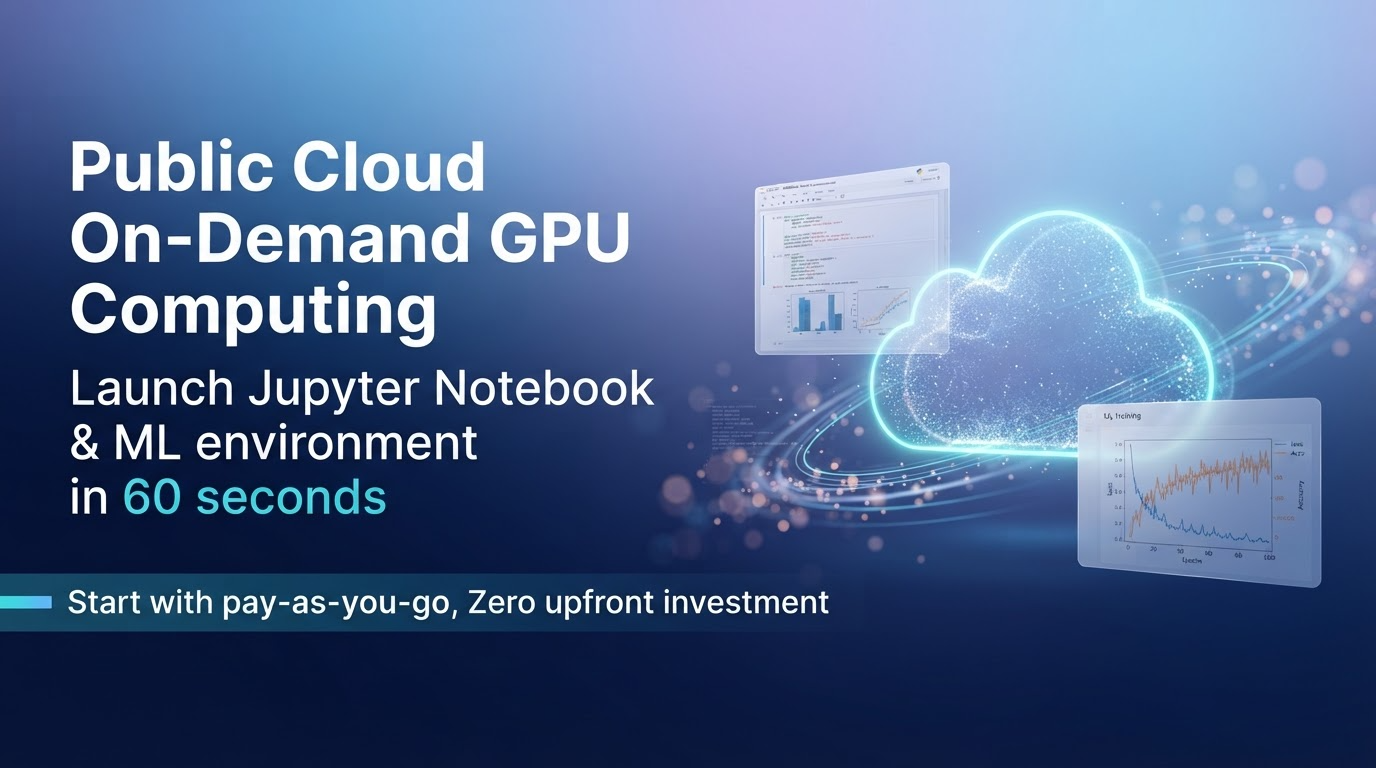
公有云
面向开发者的按需计算服务。可快速启动Jupyter Notebook和ML环境,采用按量计费模式,支持小规模起步。
- 快速启动环境 — 快速启动Jupyter Notebook和ML环境,立即开始开发。
- 按量计费模式 — 灵活的按用量付费体系,降低初始成本。
- 丰富的GPU选择 — 可从单一实例使用NVIDIA H100、A100、L40S等最新GPU。
- 开发者友好 — 通过REST API、CLI、Web控制台管理资源,可集成到DevOps工作流。
800G
InfiniBand
5,000
Max GPU
专用
Bare-Metal
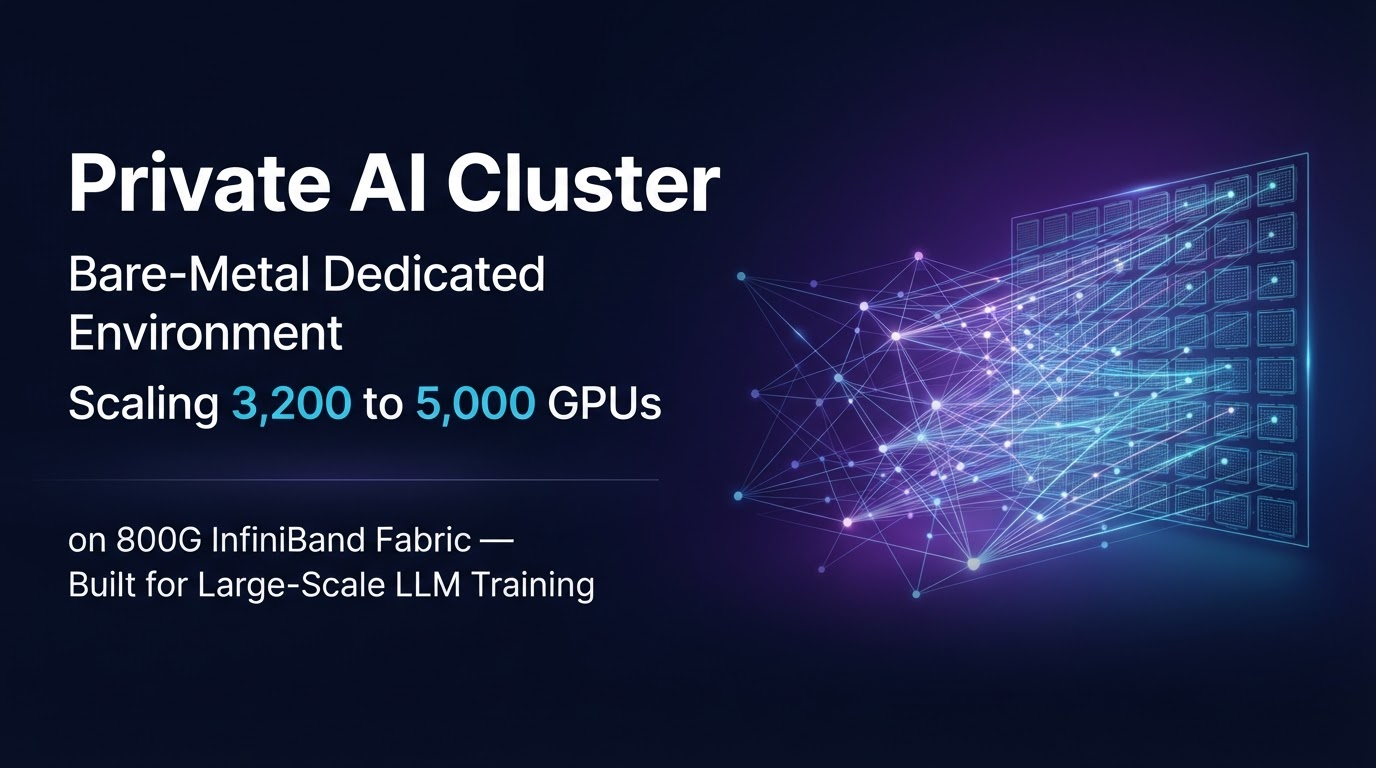
※ 800G InfiniBand及最多5,000个GPU通过合作伙伴设施提供。配置和条件将单独告知。
私有AI集群
面向Tier-1客户的裸金属集群。通过高速网络架构构建大规模GPU集群,在专用环境中实现稳定性能。可用配置和提供条件将单独告知。
超低延迟、超高带宽网络,优化GPU节点间通信。
提供适用于大规模LLM训练和仿真的GPU集群配置方案。
完全专用环境,不与其他租户共享资源,确保安全性和稳定性。
根据客户需求定制网络配置、存储、冷却系统。
基础设施配置概要
高速
网络
支持InfiniBand
大规模
GPU规模
裸金属
快速
启动时间
云环境
高可用
可用性
条件单独告知
托管AI工厂
全托管运营服务。bloomax负责建设和运营包含高速网络、NVMe分层存储、Slurm编排的环境,为客户提供专注于AI工作负载的环境。
- Slurm编排 — 使用行业标准Slurm作业调度器,高效管理大规模HPC工作负载。
- NVMe分层存储 — 结合高速NVMe SSD和大容量HDD的分层存储,优化I/O性能。
- 高速网络 — 高带宽网络优化节点间通信,提升训练效率。
- 全托管运营 — 监控、故障处理、维护全部代劳,客户可专注于AI开发。
比较三种服务形态
| 公有云GPU | 私有AI集群 | 托管AI工厂 | |
|---|---|---|---|
| 适用场景 | 开发、验证、小规模起步 | 大规模LLM训练和推理 | AI工作负载的持续运营 |
| 环境形态 | 按需使用(按量计费) | 专用(裸金属) | 全托管(详情单独告知) |
| 建设·运营负责范围 | 客户自行管理 | bloomax支持建设(运营体制单独商议) | bloomax负责建设和运营 |
| 咨询时的确认事项 | GPU类型、使用量、使用期限 | GPU数量、网络需求、安全需求 | 工作负载内容、SLA要求、运营体制 |
公有云GPU
适用场景
开发、验证、小规模起步
环境形态
按需使用(按量计费)
建设·运营负责范围
客户自行管理
咨询时的确认事项
GPU类型、使用量、使用期限
私有AI集群
适用场景
大规模LLM训练和推理
环境形态
专用(裸金属)
建设·运营负责范围
bloomax支持建设(运营体制单独商议)
咨询时的确认事项
GPU数量、网络需求、安全需求
托管AI工厂
适用场景
AI工作负载的持续运营
环境形态
全托管(详情单独告知)
建设·运营负责范围
bloomax负责建设和运营
咨询时的确认事项
工作负载内容、SLA要求、运营体制
各服务的提供条件、价格和覆盖范围将单独告知。本对比表基于目前公开的信息。
无论处于哪个阶段,均可咨询。
不清楚需要哪种GPU。正在考虑专用环境。想了解可以将多少构建和运营工作委托给外部。bloomax帮助您梳理需求与条件,为您的用途找到合适的AI基础设施方案。即使规格尚未确定,也欢迎随时咨询。
以下为预设咨询示例,并非实际导入案例。提供范围及条件将个别确认。
希望建立专属AI计算环境
适用场景
随着AI使用量的增加,正在考虑专用GPU集群。不仅关注性能,还希望综合考虑与现有系统的集成、数据处理方式以及运营体制。
咨询中梳理的内容
- 运行的AI工作负载与预计处理量
- 所需GPU配置及未来扩展计划
- 网络与存储需求
- 数据存放位置、访问管理及与现有系统的集成
- 导入时间、预算及内部运营能力
探讨的配置与推进方式
以专用GPU集群为选项,探讨涵盖计算资源、网络与存储的整体配置。明确贵方、bloomax及必要时协作的技术合作伙伴各自的职责范围,并确认导入条件。
希望减轻AI基础设施构建与运营的负担
适用场景
希望推进AI开发,但由内部团队负责基础设施构建、监控和维护存在困难。希望明确哪些工作由内部承担、哪些委托外部,并建立可持续运营的体制。
咨询中梳理的内容
- 现有设备与系统配置
- 内部负责人及可承担的工作范围
- 对监控、维护及故障响应的要求
- 更新与配置变更的推进方式
- 运营预算与所需支持范围
探讨的配置与推进方式
以托管AI工厂为选项,探讨构建与运营支持的范围。包括现有设备的可利用性,逐一明确可承担的工作、责任分工、沟通机制及合同条件。
咨询前的常见问题
以下整理了关于所需配置、费用考量及导入后运营的常见疑问,供您在咨询前参考。即使规格和条件尚未确定,也欢迎随时咨询。
可以。请从您希望通过AI实现的目标或当前遇到的问题开始告诉我们。我们将根据您掌握的信息——包括计划使用的模型、预计处理量、预算和希望时间——帮助您梳理所需条件。无需从一开始就准备详细的规格说明书。
我们将综合考虑使用期限、处理量、数据处理条件及运营体制等因素进行评估。如果您希望在开发和验证阶段灵活使用,GPU云是合适的选择;如果需要专用环境或定制化配置,则可以考虑专用集群。我们将结合费用和运营负担,帮助您比较两种方案。
综合以上条件,比较并评估最适合的服务方案。
我们会将现有设备的利用纳入方案研究范围。通过确认您现有的GPU、服务器、网络和存储配置,以及希望运行的工作负载,梳理可利用的范围和需要额外处理的事项。根据设备的规格和状态,有时可能无法直接使用,因此我们将逐一确认。
如果能提供AI的用途、预计使用规模、希望的导入时间、现有环境以及大致预算,将有助于推进讨论。所有信息无需全部确定。我们将在咨询过程中共同梳理未确定的事项,确认配置和支持范围后再告知费用。
咨询时有助于共享的信息
提供您已知的信息即可,无需全部确定
运营支持也可以咨询。根据您使用的服务,我们将梳理监控、维护、故障响应、更新和配置变更等工作的负责范围。我们将确认贵方内部负责的部分与bloomax或技术合作伙伴支持的部分,并就具体的对应内容和条件进行个别说明。
所需时间因配置要求、设备采购情况、安装环境以及与现有系统的集成和验证内容而有所不同。我们将了解您的希望时间,梳理所需准备事项和确认内容,然后告知导入的大致时间安排。如有希望的时间节点,请在咨询时告知我们。